おおくまねこ

職業プログラマーです。興味のある話題を書いています。

AI調査結果を確かめる実践的な流れ

1. はじめに

先日、以下の内容についてTwitter(現X)にポストしました。

私の調査結果と、監督者がAIを使って得た調査結果が異なり、後者を基に作業が進みそうになった事例です。 ポストには書きませんでしたが、確認すると、このAIの回答は事実と異なっていました。 本記事で扱いたいのは、私の判断が正しかったということではありません。AIを利用した調査結果を、利用者がどのように確認・評価すればよかったのか、という点です。

ありがたいことに、このポストには多くの反応をいただきました。その中に、相手が提示したAIの情報をどう確認すればよいのだろう、という趣旨の声がいくつかありました。

この記事は、まだAIの操作に自信がない人や、最近AIを使い始めて、そのアウトプットのすごさに触れた人に参考になればと思っています。

ここ1年ほど、ソフトウェア開発でのAI活用や使い方の共有が非常に活発になりました。その過程でAIの間違いを経験してきた人の中には、「出てきた情報は確認が必要」という感覚が身に付いている人もいると思います。一方、最近の自然で精度の高い回答からAIを使い始めた人は、同じ回答を見ても、想定する間違いの程度が異なるかもしれません。

冷静に考える時間があれば、確認方法を思いついたり、相手とのコミュニケーションで解決できたりする場合もあると思います。それでも、目の前で「AIはできると言っている」と言われると、どこから確かめればよいのか戸惑う人もいるのではないでしょうか。

そこで本記事では、私がソフトウェア開発でAIを使う中で普段行っている確認方法を紹介します。自分でAIに聞いて得た回答にも、第三者がAIを使って持ってきた回答にも使える方法です。


2. 結論

AIの回答は、次の流れで確認すると整理しやすくなります。

要件と前提をそろえる
    ↓
別のAIにレビューさせる
    ↓
根拠を提示させる
    ↓
一次情報や動作検証で裏を取る
確認方法 目的
別のモデル・AIによるレビュー 誤りや見落としの候補を洗い出す
判断根拠の提示 主張を検証できる状態にする
自分で裏取り 実際に要件を満たせるか判断する

別のAIが同意したことも、AIが出典を挙げたことも、それだけでは正しさの証明にはなりません。公式情報や実際の動作と照らし合わせ、根拠を確認します。


3. ハルシネーション(コンファブレーション)とは何か

ハルシネーション(Hallucination、幻覚)は、AIが事実と異なる内容や、根拠のない内容をもっともらしく生成してしまうことを指します。

米国の標準技術研究所であるNISTは、この現象を「Confabulation(コンファブレーション、作話)」と呼び、一般にはハルシネーションや捏造とも呼ばれると説明しています。

NIST AI 600-1(PDF、2.2節)

「ハルシネーション」は広く使われ、読者にも伝わりやすい言葉です。一方、「コンファブレーション」は、AIが知覚して幻を見ているかのような印象を避け、誤った内容をもっともらしく組み立てる現象として捉えやすい言葉だと思います。

この記事では一般的な呼び方に合わせて「ハルシネーション」を主に使いますが、意図的な嘘を意味するものではありません。確認したいのはAIの意図ではなく、出力と事実の差です。

技術的な相談では、次のような形で現れます。

  • 存在しないAPIや設定項目を提示する
  • 対応していない機能を「使える」と説明する
  • 異なるバージョンの仕様を混ぜる
  • 実在しないドキュメントやURLを出典として挙げる

手順やサンプルコードまで付いていると、すでに実現方法が確立しているように見えます。しかし、説明の具体性と正しさは別のものです。


4. 3つの確認方法の前に、要件と前提をそろえる

AIの回答を確認する前に、AIへ伝えた内容と実際の要件が一致しているかを確認します。

AIのいう「できる」が、次のような前提に立っているかもしれません。

  • 利用できない外部サービスを使う
  • 自動化が必要な処理を手作業で補う
  • 対象環境にはない権限や機能を使う
  • 必須条件の一部を省略する

これらはハルシネーションではなく、質問時の情報不足や前提の食い違いによって起きる場合もあります。

第三者がAIに聞いた結果であれば、「できると言っていた」という結論だけでなく、AIに入力した内容と返ってきた回答を可能な範囲で共有してもらいます。その上で、必須要件、環境、制約、成功条件をそろえます。

たとえば、次のように伝えればよいと思います。

こちらでも確認したいので、AIに聞いた内容と回答、出典のリンクを見せてもらえますか。


5. 別のモデル・AIに相互レビューさせる

まず、元の回答に誤りや見落としがないか、別のモデルやAIにレビューさせます。たとえば、Claudeで得た回答を、ChatGPTやCodexなど別のAIプロダクトにも確認させます。

レビューとは、回答を採用する前に、誤りや見落としがないかを点検することです。単に「合っていますか」と聞くのではなく、確認する観点も渡します。

以下の要件と実現案をレビューしてください。

・実在しないAPI、機能、設定項目はないか
・要件を満たしていない箇所はないか
・必要な前提条件が省略されていないか
・一次情報や動作検証で確認すべき箇所はどこか

確認できた事実と推測を区別し、
不明な点は不明としてください。

可能であれば、モデルの切り替えだけでなく、別のAIプロダクトを使うのがおすすめです。AIごとに回答の傾向や得意不得意が異なるため、異なる観点や見落としが出てくる可能性があります。多様なモデルを組み合わせて推論を改善した研究例もあります。

ReConcile: Round-Table Conference Improves Reasoning via Consensus among Diverse LLMs

別のプロダクトを使えない場合でも、モデルを変更したり、新しいセッションを開いたりする意味はあります。同じセッションでは、直前までの質問や回答がコンテキスト、つまり会話の前提情報として残ります。AIはその流れとの一貫性を保とうとして、最初の結論から離れにくくなる場合があります。会話で示された利用者の考えに合わせてしまう傾向も報告されています。

Anthropic: How people ask Claude for personal guidance

私はまず、新しいセッションで同じ要件だけを渡し、元の回答を見せずに独立した回答を出してもらいます。その後に元の回答も渡し、違いと確認すべき点を挙げてもらいます。

ただし、別のAIプロダクトが同じ結論を出しても、正しいとは限りません。複数のAIが似た情報を学習し、同じ誤りをする可能性もあります。相互レビューの役割は多数決ではなく、異なる回答や根拠から確認すべき点を増やすことです。


6. 判断の根拠になったものを提示させる

次に、「できる」と判断した根拠をAIに提示させます。

「この要件を実現できる」という回答を支える資料を示してください。

・公式ドキュメントのURLと該当箇所
・どの記述が、どの要件を満たす根拠になるか
・対象バージョン、必要な権限、利用条件
・資料に書かれた事実と、そこからの推測

確認できていない箇所は、未確認としてください。

ここで欲しいのは長い説明ではなく、こちらがたどって確認できる情報です。

URLが付いていても、そのページが存在するか、該当する記述が本当にあるか、今回の条件に当てはまるかを確認します。実在する公式ドキュメントでも、AIの主張を裏付けているとは限りません。


7. 自分で裏取りする

最後は、提示された情報を自分で確かめます。

一次情報を確認する

公式ドキュメント、仕様書、リリースノートなど、機能やサービスの提供者が公開した情報を読みます。機能の有無だけでなく、対象バージョン、権限、制限事項も確認します。

類似事例を探す

似た要件の実現例があれば、実装や検証の手掛かりになります。ただし、環境やバージョン、運用条件が異なる場合もあるため、今回と共通する条件と異なる条件を確認します。

最小構成で動作検証する

実際に試せるなら、判断を左右する部分を小さく検証します。

たとえば、「このAPIで必要な情報を取得できるか」「この権限で必要な操作が通るか」を確認します。検証前に成功条件を決め、環境、手順、期待する結果、実際の結果を残します。

コードが実行できたことと、要件を満たしたことは同じではありません。また、一度の失敗だけで技術的に不可能とも限りません。検証で確認できた範囲を明確にします。


8. 架空の例で確認の流れをたどる

ここまでの方法を、架空の例に当てはめてみます。技術的な回答で起こりやすく、主張を分解しやすい「APIで必要なデータを取得できる」という回答を例にします。

別のAIにレビューさせて、APIの存在、利用条件、取得できる項目を確認点として洗い出します。次に元のAIへ公式ドキュメントの提示を求め、最後に自分で資料と実際の応答を確認します。

確認内容を分解すると、次のような形になります。

AIの主張 確認方法 結果 次の対応
必要なAPIが存在する 公式ドキュメントを確認 確認済み 次の条件を確認する
現在の環境で利用できる 対象バージョンと権限を確認 未確認 追加調査する
そのAPIで要件を満たせる 最小構成で動作検証 不成立 別の方法を検討する

根拠が見つからない段階では誤りと断定せず、「未確認」として扱います。仕様や動作検証によって要件を満たせないと確認できた時点で、「不成立」と判断します。

最初の主張が正しくても、最後の主張まで正しいとは限りません。「何を確認できたのか」を分けることが大切です。

確認の深さは影響度で決める

すべての回答を同じ深さで調べる必要はありません。判断が外れたときの影響に応じて、確認の範囲を変えます。

判断の影響 確認の目安
低い 別のAIによるレビューと、提示された出典の確認
工数や納期に影響する 公式情報で対象条件まで確認
大きな費用や本番変更を伴う 公式情報、最小構成での動作検証、関係者による根拠の確認

9. 判断の根拠を比較する

情報の正確さを高めるには、提案ごとに判断を支える根拠を並べ、比較することが大切です。

AIが提案した方法に、私が知らない解決策が含まれている可能性はありますし、私自身の判断にも見落としはあり得ます。発言したのが人かAIかではなく、それぞれがどの条件と情報から結論を出したのかを確認します。

人による発言や提案にも、何らかの根拠があるはずです。自身の経験が根拠なら、どのような環境や条件で経験したのかを確認できます。過去に調べた内容が根拠なら、公式ドキュメントや類似事例を改めてたどれます。必要であれば、最小構成で動作を確認できます。

これは、ここまで紹介したAIの回答に対する確認方法と同じです。「できる」「できない」の両方について前提と根拠を提示し、その根拠を比較します。

たとえば、次のように進められます。

その方法で要件を満たせるなら採用したいです。まず、成立に必要な機能の公式仕様と、今回の条件で動くことを確認しましょう。未確認であれば、実装の見積もりや約束に入る前に、小さく検証したいです。

AIの提案は、調査を始めるきっかけになります。人間の経験や過去の調査も、判断を始める重要な材料です。それぞれの根拠を同じ条件で確認することで、実装を進めるための判断材料を増やせます。


10. まとめ

AIの回答を業務上の判断に使うなら、回答を受け取った後の確認までを一つの作業として考えます。

  • 別のモデル・AIにレビューさせ、疑問点を洗い出す
  • 判断を支える資料を提示させ、主張と根拠を対応させる
  • 一次情報、類似事例、動作検証で自分でも裏を取る

毎回すべてを同じ深さで調べる必要はありません。それでも、実現可否や工数、納期を左右する回答には、その影響に見合う確認が必要です。

「AIができると言っている」と言われたときに確認したいのは、どのAIが答えたかだけではありません。

どの条件で、何を根拠に、どこまで確認して「できる」と言っているのか。

自分が得た回答にも、相手が提示した回答にも、同じように確認できます。どこから確かめればよいか迷ったときに、この記事が手掛かりになればうれしいです。
生成AIを利用した監視システム設計案

1. はじめに

生成AIを監視へ活用しようとすると、多くの場合「GrafanaのスクリーンショットをOCRで読ませるべきか」「Grafana APIを使うべきか」「MCP化するべきか」という比較から考え始めます。

しかし、この考え方だけでは本質を見失います。

監視システムは「データ収集」「異常検知」「原因分析」「アクション」という複数の役割から成り立っています。AIが最も価値を発揮するのは、その中でも原因分析と意思決定の支援です。

本記事では、それぞれの技術の役割と、実務でおすすめできる構成を整理します。


2. 結論

監視システムを次の流れで考えると整理しやすくなります。

事実を取得
    ↓
異常を検知
    ↓
原因を分析
    ↓
アクションを決める
役割 担当
事実の取得 API・Exporter
異常検知 Grafana Alert / Prometheus Rule
原因分析 LLM + MCP
画面全体の補助理解・視覚的な違和感の発見 OCR / 画像理解
最終判断 人間

AIは「異常を見つける」よりも、「なぜ起きたかを説明する」ことが得意です。


3. 監視システムを4つのレイヤーで考える

レイヤー 役割 AIとの相性
データ収集 メトリクス・ログ取得 ★☆☆☆☆
異常検知 閾値判定・アラート ★☆☆☆☆
原因分析 相関分析・要約・推論 ★★★★★
アクション Runbook提示・復旧支援 ★★★★☆

データ収集

APIから正確なデータを取得します。ここはAIではなく、正確性と再現性が最優先です。

異常検知

CPU90%超過などの判定はGrafana AlertやPrometheus Ruleが得意です。LLMは毎回同じ判定を保証できないため、この層には向きません。

原因分析

AIが最も価値を発揮する領域です。メトリクス・ログ・デプロイ履歴・GitHubの変更などを横断し、「何が原因として考えられるか」を説明できます。

アクション

Runbook提示や復旧手順の提案はAIと相性が良い領域です。さらに、障害の状況や影響範囲に応じて「どのRunbookを優先するか」を判断したり、過去の類似インシデントと当時の対応結果を参照したりすることで、より実践的な復旧支援ができます。

ただし、LLMの役割はあくまで候補の提示と優先順位付けです。本番環境でのコマンド実行、設定変更、ロールバックなど、影響の大きい操作には人間の承認を必須とします。


4. OCR・API・MCPの違い

項目 OCR API MCP
取得対象 画面 データ 複数API
数値精度 △ ◎ ◎
画面全体の理解 ◎ △ △
時系列分析 △ ◎ ◎
複数システム横断 × △ ◎
自然言語との相性 ◎ △ ◎

OCR

  • ダッシュボード全体の雰囲気を把握できる
  • 注釈やレイアウトも理解できる
  • 色、グラフ形状、パネル配置などの視覚的な変化を素早く捉えられる
  • 細かな数値は信用しすぎない

OCRや画像理解の価値は、表示された数値を正確に読み取ることだけではありません。たとえば、普段は緑色のパネルが赤くなっている、特定のグラフだけ急に形が変わっている、パネルが欠落・崩落しているといった、ダッシュボードの視覚的な異常を素早く発見できます。

これは「何かおかしい気がする」という直感的な調査トリガーとして有用です。一方で、正確な値、継続時間、複数期間の比較などを根拠に判断する場合は、OCRの結果を確定情報にせず、必ずAPIやメトリクスストアから構造化データを取得して検証します。

API

  • 正確な数値取得
  • 時系列分析
  • 自動化・バッチ処理に最適

MCP

  • LLMが必要な情報を自律的に取得
  • Grafana・GitHub・Lokiなどを横断
  • アドホックな調査に強い

5. Grafanaを例に考える

スクリーンショットで十分なケース

  • 「この画面、何か気付くことは?」
  • ダッシュボード全体の傾向を把握したい

APIが必要なケース

  • CPU95%以上が何分続いたか
  • p95レイテンシを比較したい

MCPが活きるケース

  • 「昨日のデプロイ後から遅い原因を調べて」
  • 複数システムを横断して調査したい

6. AIに向いている仕事・向いていない仕事

向いている 向いていない
要約 閾値判定
原因分析 厳密な数値判定
相関分析 SLA判定
横断調査 リアルタイム制御

AIは「事実」を作るより、「事実をつないで意味を説明する」ことが得意です。


7. 実運用で考えるべきポイント

Baseline

正常時を知らないAIは異常を正しく判断できません。基準値は監視システム側で管理し、分析時に必要な範囲をLLMへ渡します。

たとえば、次のような情報をBaselineとして用意します。

  • 同じ曜日・時間帯における過去4週間の平均値、中央値、分位点
  • 通常時の変動幅や、許容される上限・下限
  • デプロイ前や障害発生前の比較対象期間
  • サービス、環境、顧客区分など、比較条件を揃えるための属性

生の長大な時系列を常に送るのではなく、「通常はp95レイテンシが180~230ms」「現在は520msで通常上限の約2.3倍」のような要約をContextへ含めると、トークン量を抑えながら判断根拠を明確にできます。

Context

デプロイ履歴、PR、ログ、Runbook、過去の類似インシデントなど、周辺情報があるほど分析精度は向上します。ただし、すべての情報を無条件に渡すとノイズとコストが増えるため、アラートの対象サービスと時間帯に関連する情報を自動で切り出す設計が重要です。

たとえば、アラート発生時刻の前後30分の時系列、直前のデプロイ、同じ時間帯に増加したエラーログを取得し、LLMへまとめて渡します。最初の分析でDB遅延が疑われた場合だけDBメトリクスを追加取得するなど、分析結果に応じてContextを段階的に広げる方法も有効です。

Explainability

「Redisが怪しい」ではなく、「CPU・Latency・Deploy履歴からそう判断した」と説明できることが重要です。

Cost

すべてのアラートをLLMへ送るのではなく、重大なものだけ分析対象にすると費用を抑えられます。

Human in the Loop

復旧提案と優先順位付けはAI、本番反映は人間。この役割分担が安全です。AIには、単にRunbookを検索させるだけでなく、症状・影響範囲・過去の成功事例を根拠に候補を並べさせます。そのうえで、実行対象、手順、想定影響、ロールバック方法を人間が確認してから実行します。


8. おすすめ構成

Prometheus
    │
Grafana Alert
    │
重大アラート
    │
   MCP ──┬─ Grafana API
    │    ├─ Prometheus API
    │    ├─ Loki
    │    ├─ GitHub
    │    └─ Kubernetes
    │
   LLM ──┬─ 原因分析
    │    ├─ 優先順位付け
    │    ├─ Runbook提示
    │    └─ 類似インシデント参照
    │
人間が承認
    │
   実行

メリット

  • 判定はルールベースで安定
  • AIは分析に集中できる
  • APIの正確性とAIの推論力を両立

デメリット

  • MCPサーバーの開発・テスト・継続運用が必要
  • API設計に加え、認証・認可と最小権限の設計が必要
  • ユーザーや環境ごとのアクセス制御、資格情報の安全な管理が必要
  • レート制限、タイムアウト、再試行、取得量の上限などの保護策が必要
  • 誰が、いつ、どのToolで、何を取得・実行したかを追跡する監査ログが必要
  • Toolの追加・変更時には、LLMによる選択ミスや意図しない組み合わせも検証する必要がある

特に本番環境で複数システムを横断させる場合、MCPサーバーを実装する作業そのものよりも、セキュリティとガバナンスの設計・運用がボトルネックになりやすい点に注意が必要です。

MCPを導入しても、接続先APIの権限管理や監査が自動的に解決するわけではありません。読み取り専用Toolから始め、参照可能な環境・期間・データ範囲を制限し、書き込みや復旧操作は別の権限境界に分ける設計が現実的です。

この構成を採らない場合

  • AIだけ:誤判定や数値誤認識のリスク
  • Ruleだけ:原因分析が人手依存
  • APIだけ:複数システムを横断した柔軟な調査が難しい

9. まとめ

OCR・API・MCPは競合するものではありません。

  • APIは「事実を取得する」
  • Rule Engineは「異常を検知する」
  • MCPは「必要な情報を集める」
  • LLMは「原因を分析し説明する」
  • 人間は「最終判断をする」

この役割分担を意識することで、AIを無理に監視の中心へ据えるのではなく、AIの強みを最大限に活かした監視システムを設計できます。

監視で本当に重要なのは、「どのAIを使うか」ではなく、「AIをどのレイヤーで使うか」です。

Codexの個人用アクセストークンを取得する

Codex CLIをAPIキーで認証する方法

はじめに

Codex CLIでは、一般的に次のコマンドを実行し、ブラウザからChatGPTへログインします。

codex login

ただ今回は、ChatGPTアカウントではなく、OpenAI Platformで発行したAPIキーを使ってCodex CLIを動かしてみたくなりました。

最初は、環境変数 OPENAI_API_KEY を指定した状態でCodexを起動すればよいのではないかと考えていました。

OPENAI_API_KEY=<copied_key> codex

調べてみると、現在のCodex CLIには、APIキーを使って正式にログインするためのコマンドが用意されています。

この記事では、実際にAPIキーを発行してCodex CLIへログインした手順と、ChatGPTログインとの違いをまとめます。

Codex CLIで利用できる認証方法

Codex CLIでは、主に次の2種類の認証方法を利用できます。

認証方法 料金の扱い 向いている用途
ChatGPTアカウント ChatGPTプランの利用枠 個人での対話的な利用
OpenAI APIキー OpenAI APIの従量課金 API利用やCI/CDなどの自動化

今回は、OpenAI APIキーを使った方法を試します。

APIキー認証を使用した場合、ChatGPTの利用枠ではなく、OpenAI APIの利用量に応じた料金が発生します。

APIキーでログインする手順

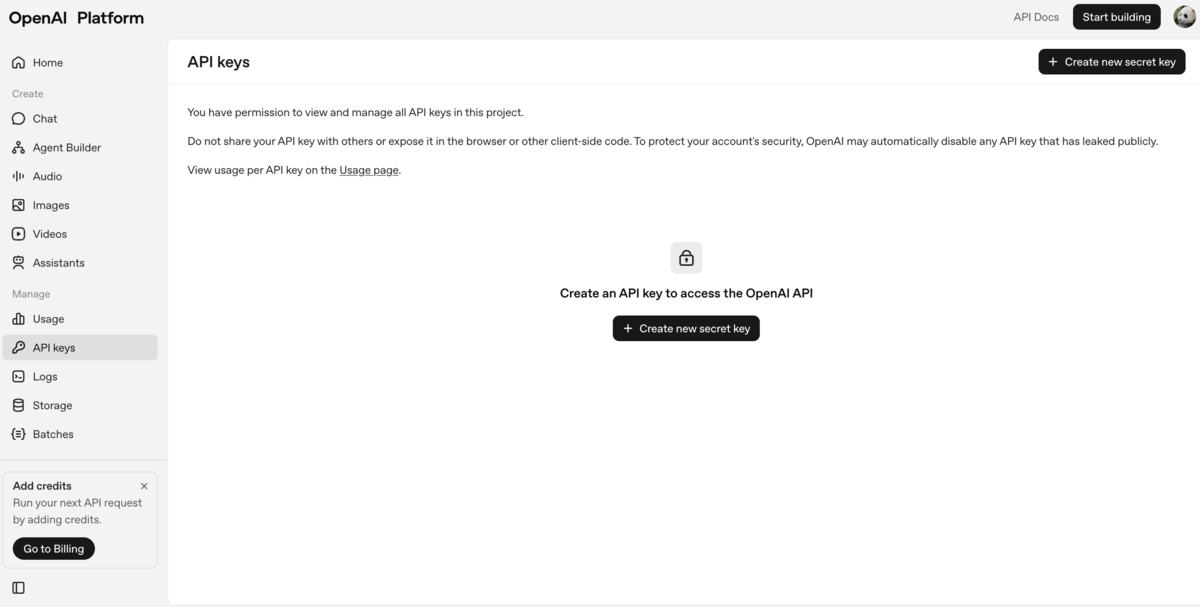
1. OpenAI Platformの「API keys」画面を開く

次のページへアクセスします。

OpenAI Platform「API keys」

APIキーを作成するには、OpenAI Platformへのログインが必要です。

2. 「Create new secret key」を押す

API keys画面にある「Create new secret key」を押します。

3. APIキーを作成する

APIキーの名前など、必要な情報を入力して作成します。

キー名は、あとから見たときに用途が分かる名前にしておくと管理しやすくなります。

例えば、ローカル環境のCodex CLIで使用する場合は、次のような名前が考えられます。

codex-cli-local

複数のPCや用途でAPIキーを使う場合は、用途ごとにキーを分けておくと、不要になったキーだけを無効化できます。

4. APIキーをコピーする

APIキーを作成すると、「Save your key」ダイアログに発行されたキーが表示されます。

コピーボタンを押して、APIキーをコピーします。

発行されたAPIキーの全文を確認できるのは、基本的に作成直後だけです。画面を閉じる前にコピーしておきます。

APIキーはパスワードと同じ認証情報です。ソースコードへ直接書いたり、Gitリポジトリへコミットしたり、第三者へ共有したりしないように注意してください。

万が一、APIキーを公開してしまった場合は、そのキーを削除し、新しいキーを発行します。

5. APIキーを環境変数へ設定する

取得したAPIキーを、環境変数 OPENAI_API_KEY へ設定します。

macOSまたはLinuxの場合は、次のように設定します。

export OPENAI_API_KEY="<copied_key>"

PowerShellの場合は、次のように設定します。

$env:OPENAI_API_KEY = "<copied_key>"

<copied_key> の部分を、先ほどコピーしたAPIキーへ置き換えます。

APIキーをコマンドへ直接書くと、使用しているシェルによっては履歴に残る可能性があります。共有PCなどで実行する場合は、特に注意が必要です。

6. Codex CLIへAPIキーでログインする

環境変数へ設定したAPIキーを、標準入力からCodex CLIへ渡します。

macOSまたはLinuxの場合は、次のコマンドを実行します。

printenv OPENAI_API_KEY | codex login --with-api-key

PowerShellの場合は、次のように実行します。

$env:OPENAI_API_KEY | codex login --with-api-key

これで、APIキーを使ったログインは完了です。

7. 認証状態を確認する

次のコマンドを実行すると、現在の認証状態を確認できます。

codex login status

APIキーによる認証が確認できたら、Codex CLIを起動します。

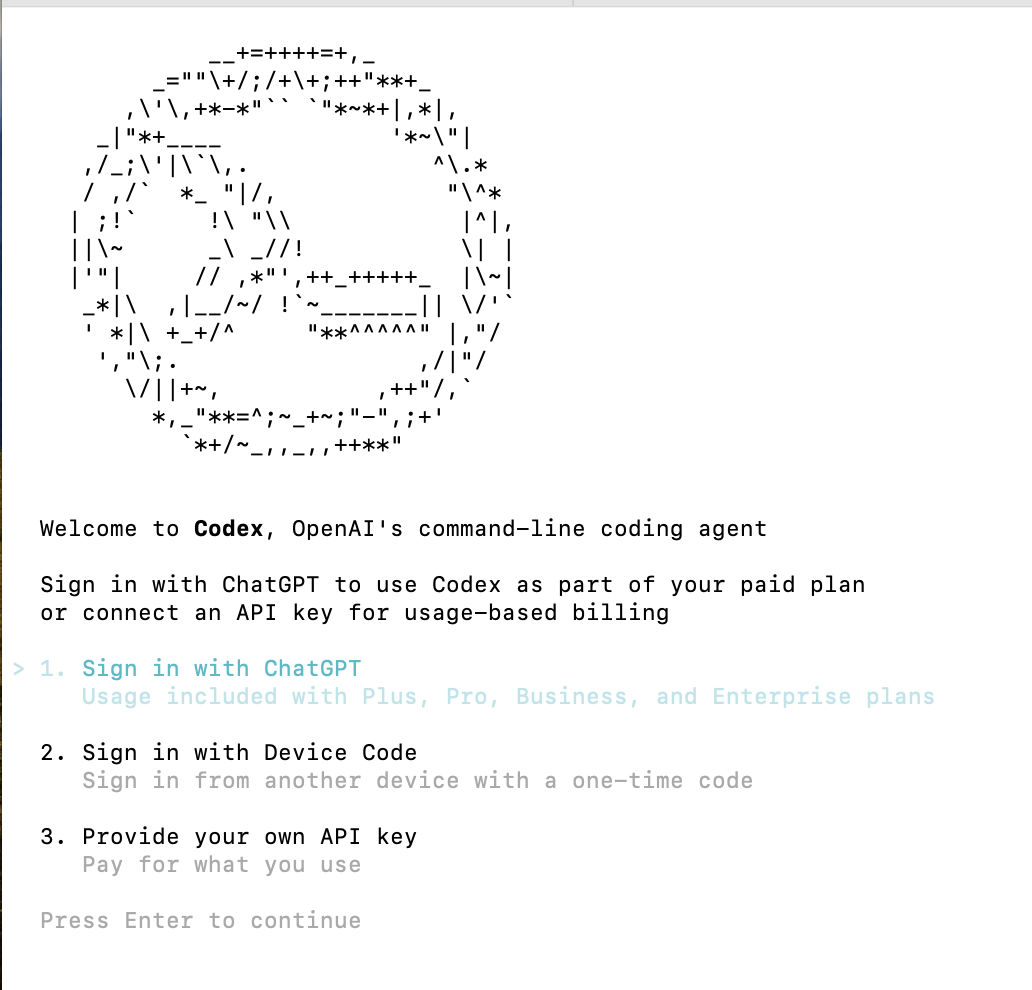
codex

無事に起動できました。

ところで、起動時に表示されるこのマークは何なのでしょうか。

Codexのロゴ……でしょうか。

起動するたびにAPIキーを指定する必要はあるか

最初は、Codexを起動するたびに次のようにAPIキーを渡す必要があると思っていました。

OPENAI_API_KEY=<copied_key> codex

しかし、公式に案内されている方法では、最初に次のコマンドでAPIキーを使ってログインします。

printenv OPENAI_API_KEY | codex login --with-api-key

ログイン後は認証情報がローカルに保存されるため、通常は起動するたびにAPIキーを指定する必要はありません。

以降は、次のコマンドだけでCodex CLIを起動できます。

codex

毎回APIキーをコマンドへ記載しなくてよいため、操作が簡単になるだけでなく、シェルの履歴にAPIキーが残る危険も減らせます。

ChatGPTログインとの違い

ChatGPTアカウントでログインする場合は、次のコマンドを実行します。

codex login

ブラウザが開き、ChatGPTへのログインを求められます。

一方、APIキーを使う場合は、次のコマンドでログインします。

printenv OPENAI_API_KEY | codex login --with-api-key

実際に起動して使ってみた範囲では、ログイン後の基本的な操作感に大きな違いは感じませんでした。

ただし、見た目や操作感が似ていても、内部では料金の扱いが異なります。

ChatGPTログインでは、契約しているChatGPTプランの利用枠が適用されます。APIキー認証では、OpenAI Platform側でAPIの利用料金が発生します。

また、APIキー認証では、ChatGPTのワークスペースやクラウドサービスに依存する一部の機能が制限される場合があります。

単にローカル環境でCodex CLIを対話的に使いたい場合は、ChatGPTログインの方が手軽だと思います。

一方、次のような場合はAPIキー認証が向いています。

  • ChatGPTとは別にAPIの利用料金を管理したい
  • CI/CDなどの自動実行で利用したい
  • ブラウザログインが難しい環境で利用したい
  • OpenAI Platformの組織やプロジェクト単位で利用状況を管理したい

認証後の画面だけを見ると違いが分かりにくいため、「ログインできればどちらでも同じ」と考えてしまいそうですが、料金体系や利用できる機能には違いがあります。

目的に応じて認証方法を選ぶ必要がありそうです。

ログアウトする方法

保存された認証情報を削除したい場合は、次のコマンドを実行します。

codex logout

ログアウト後にCodex CLIを起動すると、あらためてログインを求められます。

ChatGPTログインからAPIキー認証へ切り替える場合や、別のAPIキーを使用する場合にも、いったんログアウトしてからログインし直すと分かりやすいです。

まとめ

Codex CLIは、ChatGPTアカウントだけでなく、OpenAI APIキーを使ってログインできます。

APIキーを使う場合の基本的な流れは、次のとおりです。

  1. OpenAI PlatformでAPIキーを作成する
  2. APIキーを環境変数 OPENAI_API_KEY へ設定する
  3. codex login --with-api-key でログインする
  4. codex login status で認証状態を確認する
  5. codex を実行する

実際に試してみると、ログイン後の操作感はChatGPTログインと大きく変わりませんでした。

しかし、APIキー認証ではOpenAI APIの従量課金が適用されます。普段使いならChatGPTログイン、自動化やAPI側での利用管理が必要ならAPIキー認証、という使い分けが分かりやすそうです。

個人的には、「APIキーを環境変数へ設定して、毎回Codexを起動する」というイメージを持っていました。しかし実際には、APIキーにも専用のログインコマンドがあり、一度認証すれば通常の codex コマンドで起動できました。

試してみるまで、この違いを理解できていなかったため、同じようにAPIキーでCodex CLIを使いたい人の参考になればと思います。

参考

Macで自作バイナリを実行するときに実行ブロックされた時の対応

はじめに

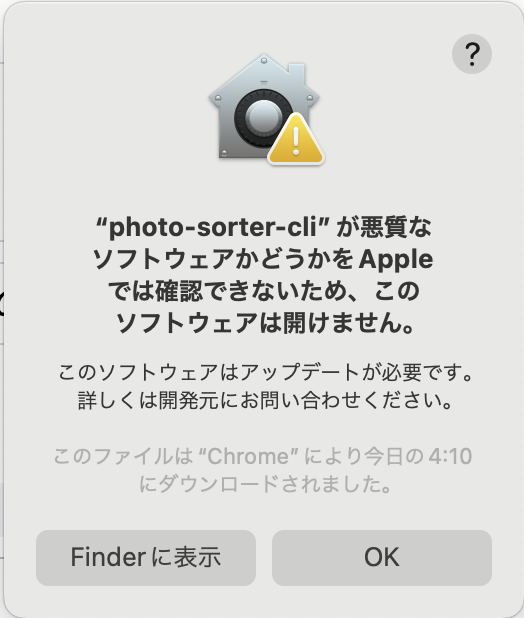
GoやRustでNativeバイナリを作成し、実行する時にポップアップが表示されて実行ができない。

MacOSには Gatekeeper という機能により、Appleによる署名や公証バイナリのチェックがなされ、確認を通過できないと実行させない仕組みがある。

その時の対処方法。

正攻法

バイナリ側にAppleの認証が通るように設定してもらう。
- Developer ID
- Apple notarization

配布側に依頼できるのであれば、対応してもらうのが一番良いと思われる。

一時的に許可。バイナリを半強制的に実行する。

以下の手順
1. Finderから対象のバイナリを右クリックし、「開く」を選択。
2. 「開いてもよろしいですか?」のような確認がされるので、「開く」を選択。
3. バイナリは実行される。

一度許可すれば、効果が有効な間は再度の実行やCLIからの実行も可能になるようだ。

一時的に許可。システム設定から許可

  1. バイナリを実行
  2. 「〜Appleでは確認できないため、このソフトウェアは開けません」が出る。
  3. この状態でMacの「システム設定」を開き「プライバシーとセキュリティ」を選択、「このまま開く」を選択

実行可能になる

CLI操作によるquarantine除去による検証スキップ

xattr -d com.apple.quarantine </path/to/binary>

バイナリ単位でquarantineを操作して認証をスキップする。

参考 - keith.github.io - support.apple.com

Codexをはじめよう with VSCode

はじめに

コード生成型のAIをつかうための情報を記載する。

選択肢としては複数あると思うが、私はChatGPTの有料プラン(Plus)に加入していたので、Codexも使ってみようと思いました。

IDE連携もできるので、そちらを使おうと思います。

CursorやWindsurfなどでも使えるようですが、今回は多少使っているVisualCodeを使う前提について記載します。

参考: Codex IDE extension

Codexとは

OpenAI製のコード生成AI機能。コード生成AIは人間が言葉でプロンプトから指示することで既存コードの解析・修正・リファクタリングなどをすることが可能。

GitHub 上の膨大な公開ソースコードを学習しているらしい。

個人的には複雑なコードや新しいプロジェクトの説明や、ユニットテストの実装を補助してもらえるのは非常に助かると思う。

対象のChatGPTの有料プラン

ChatGPTの有料プランに入っていればCodexを利用可能らしい。 - ChatGPT Plus - ChatGPT Pro - ChatGPT Team / Business / Enterprise - ChatGPT Edu

導入手順

PCからの操作を前提にします。

ChatGPTのブラウザを開く。

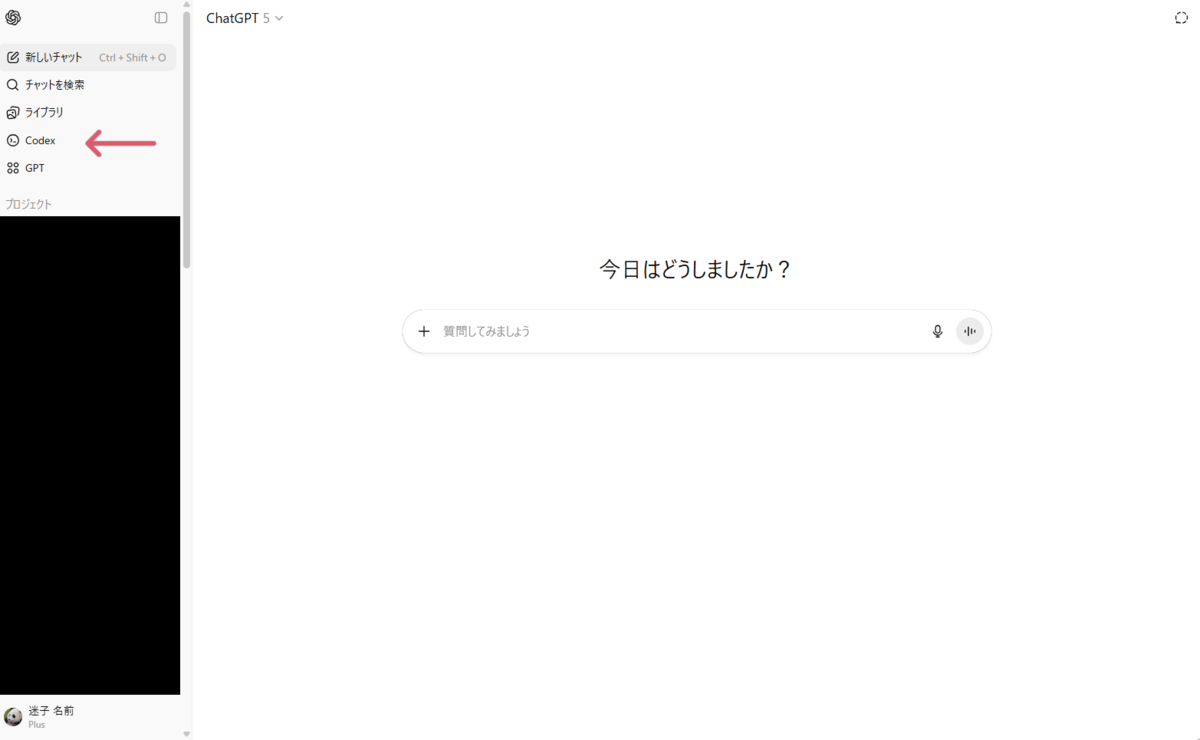
左側のサイドバーにある「Codex」をクリックし、ブラウザの別タブからCodexのブラウザ画面を開く。

GitHubと連携、認証を行う。

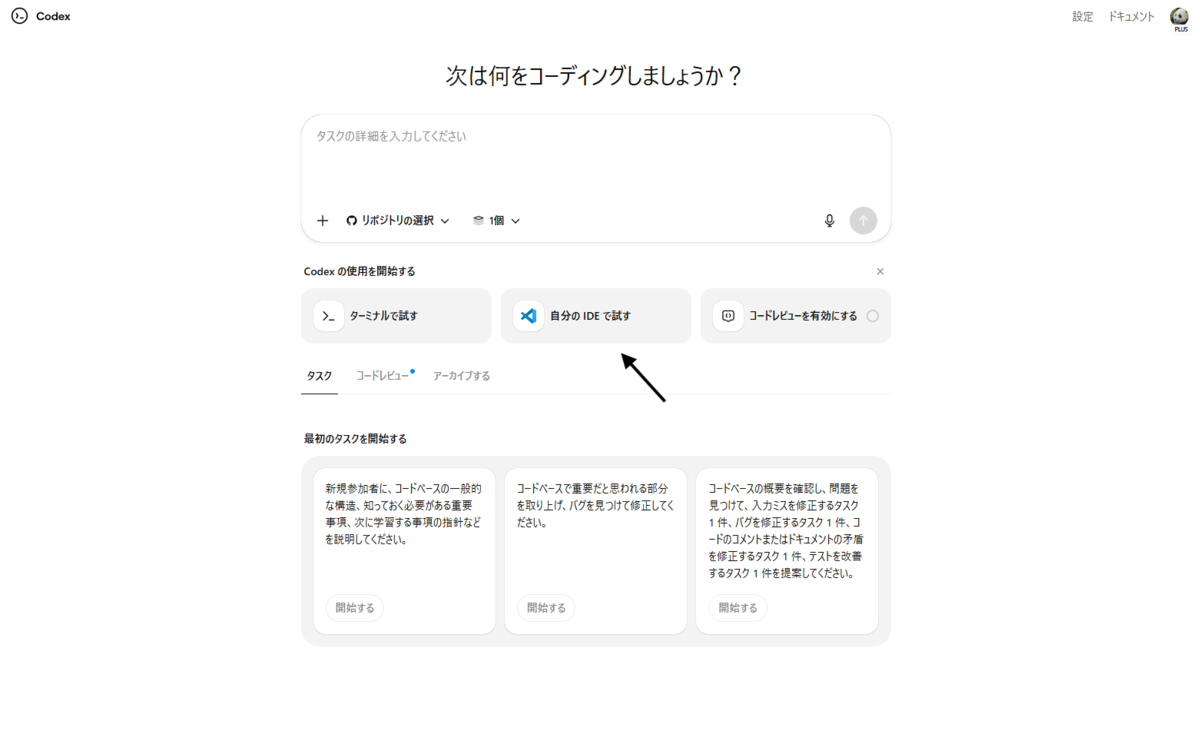
「自分のIDEで試す」をクリックして、IDEを起動する。

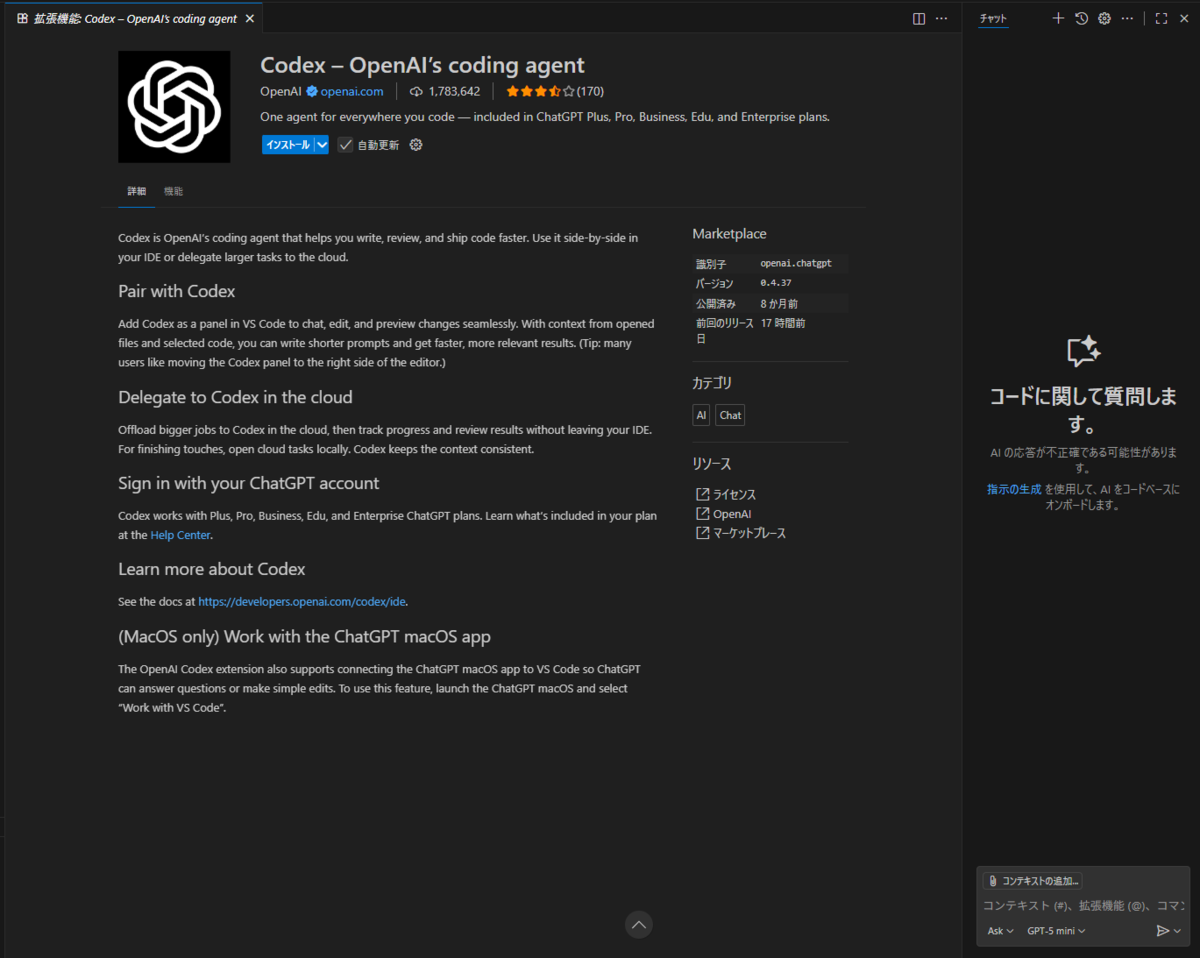
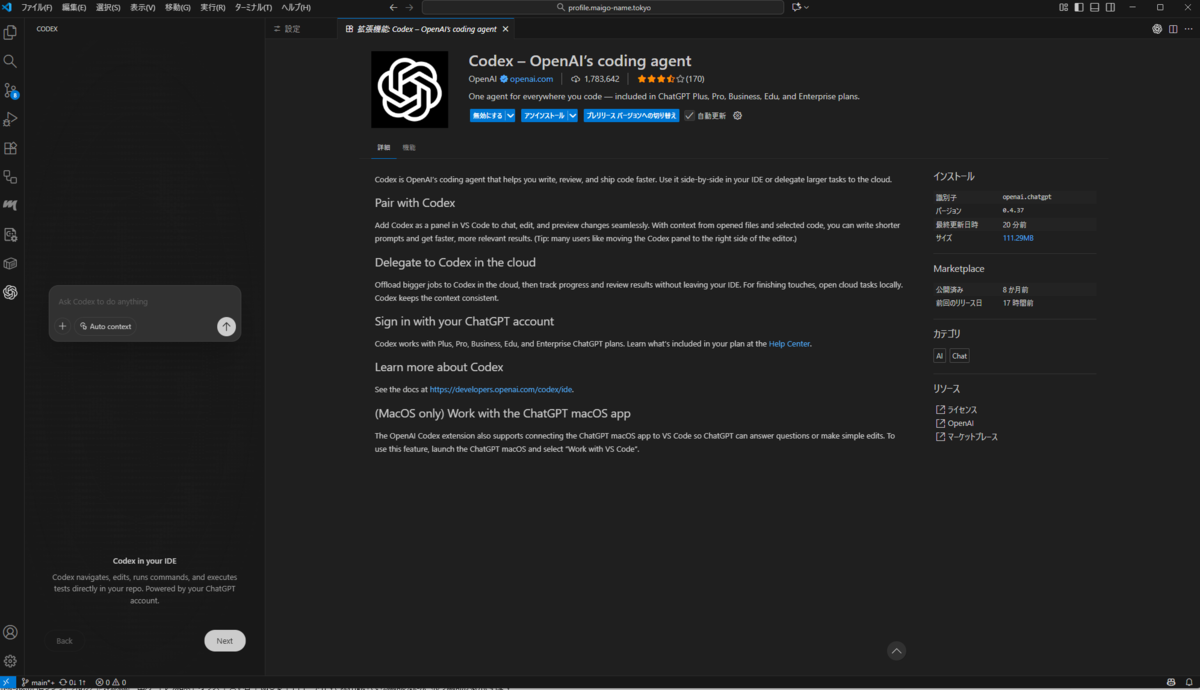
Codexの拡張機能を追加する。 ※見失った場合、拡張機能(Ctrl+Shift+x)でcodexで検索して拡張機能を探すことも可能。

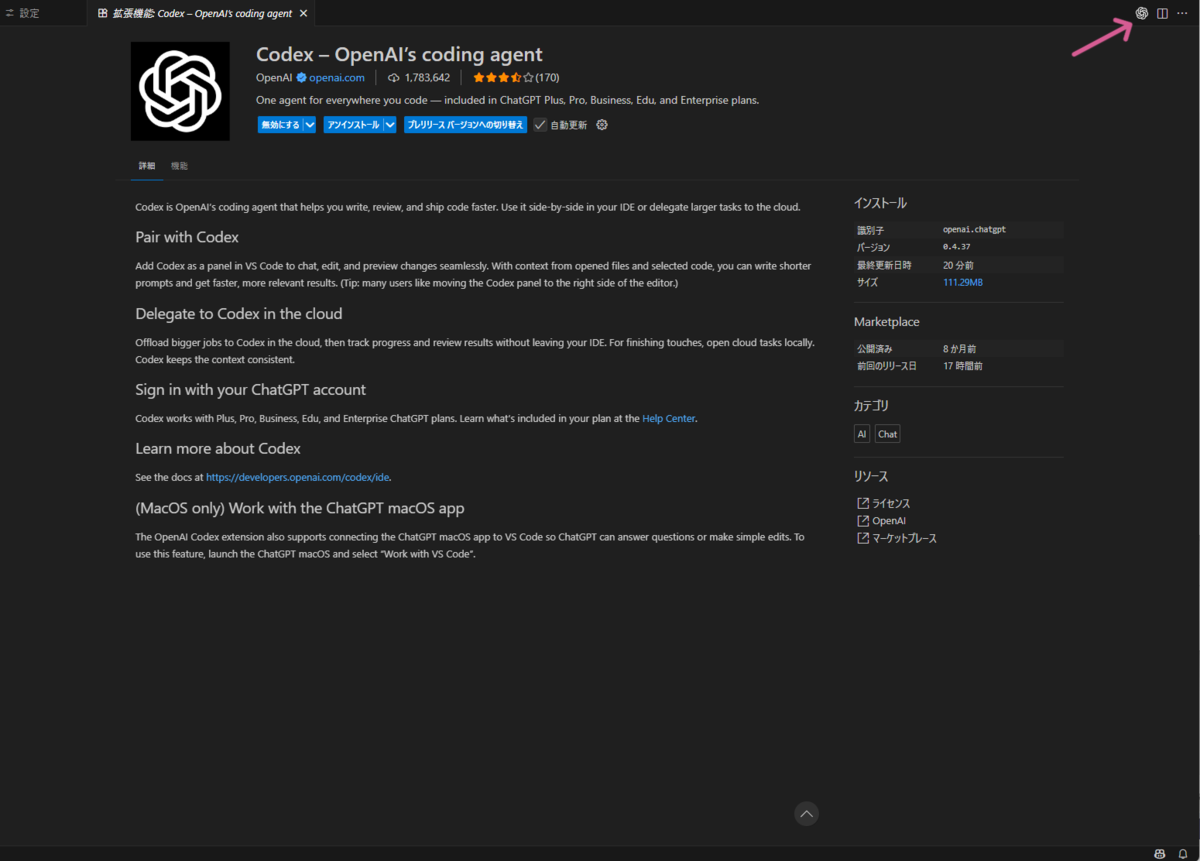
拡張機能を追加後、右上にChatGPT風のアイコンが出てくる。クリックしてCodexを起動。

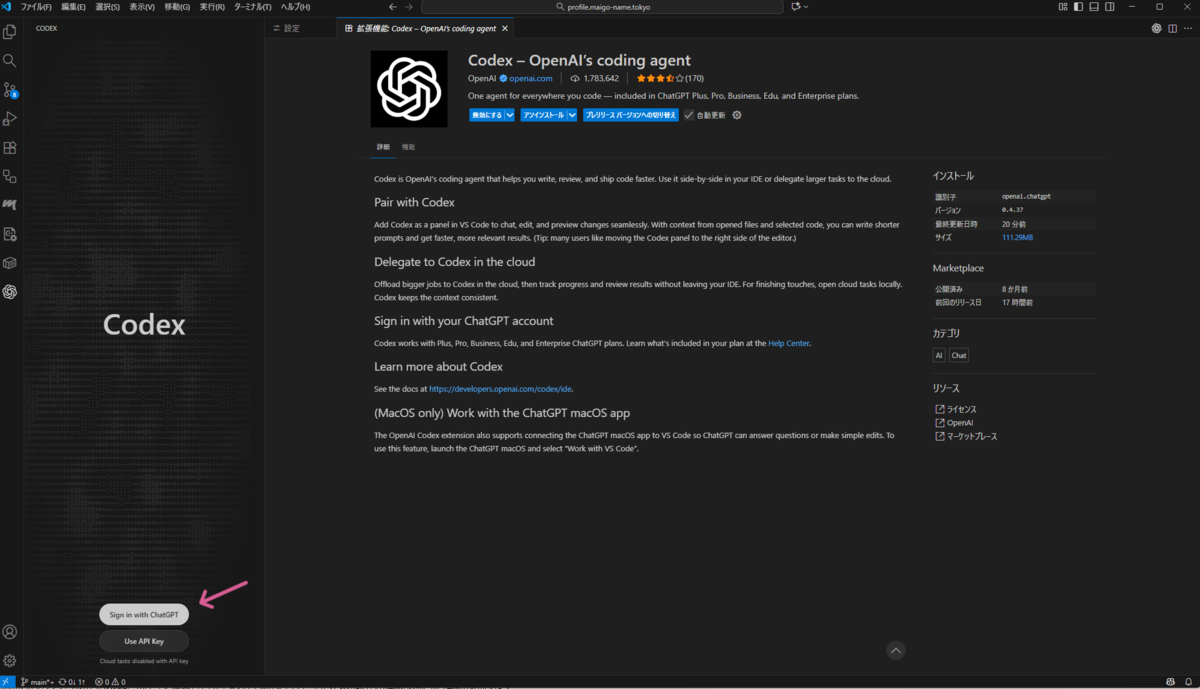
ChatGPTと連携する。API Keyを設定する方法、ChatGPTにサインインする方法があるが、今回はサインインする。

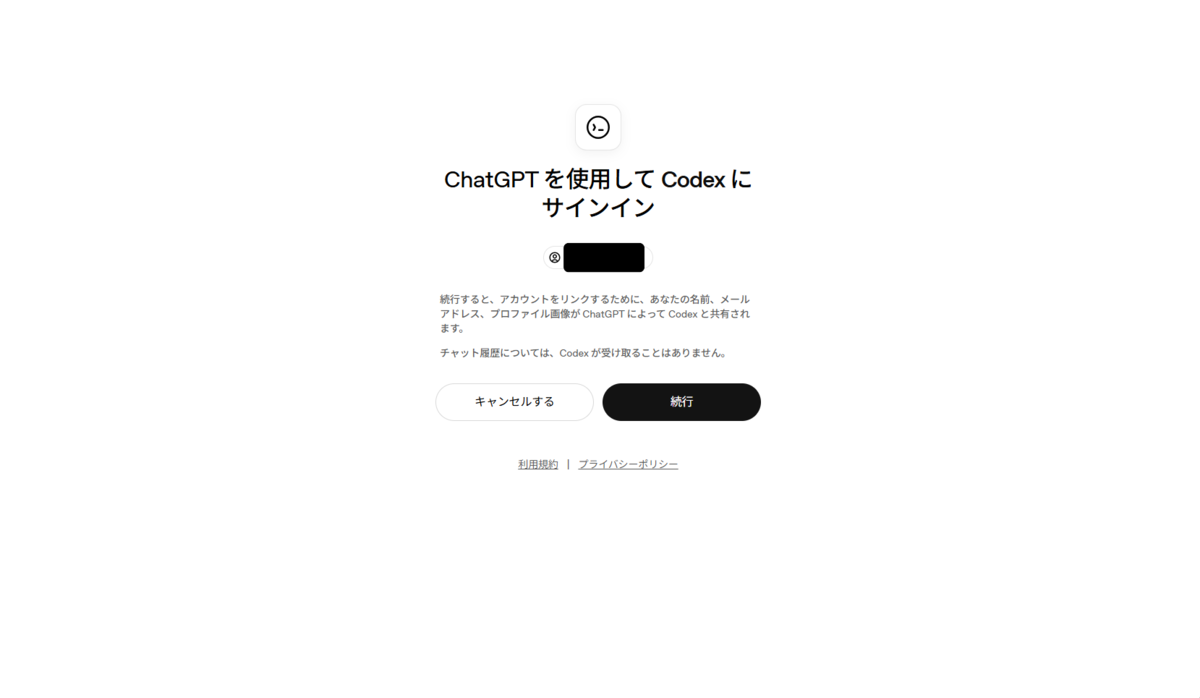
サインインボタンをクリックすると、ブラウザが開いてChatGPTへのログインが促される。ログインして「ChatGPT を使用して Codex にサインイン」を続行する。

「Signed in to Codex」に画面が変わったら、IDEにもどる。

画面にCodexのターミナルがつかえるようになる。チュートリアル的な説明があるので、適宜必要な個所を確認し、Nextを押して進んでいく。

ターミナルに入力できるようになったら利用開始の準備は完了。

タスクの入力をプロンプトから入れたりできる。Chatモード、AgentモードやAIモデルの選択をしたりもできるので必要に応じてカスタマイズする。

以上、おつかれさまでした。

ソースコードレビューの考え方

私が考えるソースコードレビュー

はじめに

ソースコードレビューには、バグの発見、品質の維持、知識の共有など、さまざまな目的があります。一方で、レビューをする側にも、される側にも、時間的・精神的な負担がかかります。

だからこそ、限られた時間と集中力を、価値の高い判断に使うことが重要だと考えています。

変更されたすべての行を、人間が同じ密度で確認することが最善とは限りません。文法、フォーマット、単純なコード規約など、機械的に判定できるものはLinterやCIに任せます。そのうえで人間は、仕様の解釈、処理全体の整合性、想定外の使われ方、将来の変更しやすさなど、人間による判断が必要な部分に集中します。

レビューの目的は、細かな間違いをできるだけ多く指摘することではありません。重大な問題を見つけ、チームとしてより良い変更を本番へ届けることです。

この記事では、私がソースコードレビューで意識している目的、進め方、確認観点、コミュニケーション、仕組みづくりについて整理します。

本記事の「重要度」は、レビュー時に人間が確認へ割くべき優先度を表します。重要度が低い項目も不要という意味ではありません。自動化できるものは機械に任せ、人間は高度な判断に集中するという考えに基づいています。

ソースコードレビューを行う目的

バグを早期に発見する

ソースコードレビューの代表的な目的は、実装者が見落とした不具合や考慮漏れを、本番へ反映する前に発見することです。

実装者は、仕様や実装意図をもっとも深く理解しています。その一方で、実装中に作った前提を無意識に補いながらコードを読むため、自分では違和感に気づきにくいことがあります。

第三者が異なる視点から確認することで、正常系だけでなく、例外、境界値、想定外の入力、既存機能への影響などを発見しやすくなります。

ソースコードの秩序を維持する

ソースコードは、一度動けば終わりではありません。機能追加、不具合修正、仕様変更を繰り返しながら、長い期間にわたって保守されます。

そのため、今回の実装が動くかだけでなく、既存の設計や責務と整合しているか、将来変更しやすいか、ほかのメンバーが読めるかも確認します。

レビューは、一時的な実装の都合によってコード全体の秩序が崩れることを防ぐ機会でもあります。

品質に対する責任と知識をチームで共有する

レビューを通じて、実装内容や設計意図を実装者以外も理解できます。これにより、特定の人だけが仕様や背景を知っている状態を防げます。

これは「レビューアーにも責任を負わせる」という意味ではありません。品質を個人だけの問題にせず、より良いソフトウェアを届ける責任と知識を、チームで共有するという意味です。

レビューに対する基本的な考え方

すべての行を同じ密度で確認しない

変更量とリスクは、必ずしも比例しません。

単純な値の受け渡しが100行追加された変更より、決済可否を判断する条件式が1行変更された方が、慎重な確認を必要とすることがあります。数千行の差分でも、その大部分が自動生成コードやテストデータであり、本質的な業務ロジックは数百行という場合もあります。

そのため、行数だけで重要度を判断せず、変更の意味と影響に応じて確認の深さを変えます。

人間の集中力を価値の高い判断に使う

レビューで使える時間と集中力には限界があります。

フォーマット、単純な命名規則、静的に検出できる問題などに人間の集中力を使い切ると、仕様の誤解や状態遷移の不整合など、重大な問題を見落としやすくなります。

機械に任せられる確認を自動化し、人間は「仕様として正しいか」「システム全体として安全か」「将来も保守できるか」といった判断に集中します。

レビューアーの進め方

レビューを始めるときの流れ

私は、おおむね次の順序でレビューを進めます。

  1. PRの目的、背景、仕様を確認する
  2. 変更ファイルの一覧を見て、変更の全体像をつかむ
  3. 変更を種類ごとに分類する
  4. 処理の入口と出口を特定する
  5. 主要な正常系を追う
  6. 失敗系、境界値、状態遷移を追う
  7. テストが仕様やリスクに対応しているか確認する
  8. 変更の外側への影響と保守性を確認する
  9. コメントを投稿する前に、変更の必要性と伝え方を再確認する

これは必ず守る手順ではありません。変更の種類や規模に応じて順序は変えますが、差分の先頭から一行ずつ読み始めるのではなく、まず「何を変えるPRなのか」を理解することを重視しています。

PRの目的と全体像を確認する

重要度:最高

レビューの入口はコードではなく、変更の目的です。

最初に、次の点を確認します。

  • 何を実現、修正するPRなのか
  • なぜ変更が必要なのか
  • 期待する動作は何か
  • 変更しない範囲はどこか
  • 受け入れ条件は何か

目的を理解しないまま差分を読むと、各行が文法的に正しいことは確認できても、そもそも必要な仕様を満たしているか判断できません。

PRの説明だけで判断できない場合は、チケット、仕様書、関連する既存コードなども確認します。

コードを構造化して捉える

重要度:高

変更されたコードを一行ずつ同じように読むのではなく、まず変更全体を構造化して捉えます。

例えば、変更を次のように分類します。

  • 新しく追加された業務ロジック
  • 既存処理の変更
  • インターフェースやデータ構造の変更
  • テストコードの追加・変更
  • 機械的なリネームやフォーマット変更
  • 自動生成されたコード
  • 設定ファイルや依存ライブラリの変更

最初に分類することで、今回の開発における本質的な変更がどこにあるのかを把握しやすくなります。

ファイル単位だけでなく、処理上のまとまりとして理解することも意識します。

リクエストを受け取る
    ↓
入力値を検証する
    ↓
業務ロジックを実行する
    ↓
データベースを更新する
    ↓
結果を返す

このようにコードを意味のある処理単位へ分けると、変更の目的、処理同士の関係、確認すべき箇所が見えやすくなります。

システムの動作をイメージしながら確認する

重要度:最高

差分だけを見るのではなく、そのコードが実際に動いたとき、システムの中で何が起きるのかをイメージします。

例えばAPIの処理であれば、次のような流れを頭の中で追います。

利用者がリクエストを送る
    ↓
認証・入力チェックを行う
    ↓
対象データを取得する
    ↓
状態を変更する
    ↓
データベースへ保存する
    ↓
外部サービスや後続処理へ通知する
    ↓
利用者へ結果を返す

正常に処理された場合だけでなく、途中で失敗した場合も考えます。

  • 入力値が不正だった場合にどうなるか
  • 対象データが存在しなかった場合にどうなるか
  • データベースの更新に失敗した場合にどうなるか
  • 一部だけ成功した状態で例外が発生しないか
  • 同じ処理が複数回実行されても問題ないか
  • 別の処理が並行して実行された場合に整合性を保てるか
  • 外部サービスが応答しなかった場合にどうなるか

各行が正しく見えても、処理全体を通して見ると問題が見つかることがあります。「このコードは正しいか」だけでなく、「このコードが動いた結果、システムが期待する状態になるか」という視点で確認します。

リスクの高い箇所を重点的に確認する

重要度:最高

すべてのコードを同じ強さで疑うのではなく、問題が起こりやすい箇所や、起きた場合の影響が大きい箇所に確認を集中させます。

特に注意するのは、次のような場所です。

  • 条件分岐や複雑な判定
  • 境界値、null、空文字、ゼロ件の扱い
  • 状態遷移
  • 権限や認証の判定
  • データの登録、更新、削除
  • トランザクションの範囲
  • 並行処理や排他制御
  • エラー処理やリトライ
  • 外部サービスとの通信
  • 後方互換性に関わる変更
  • 性能に影響する繰り返し処理やデータ取得
  • 既存の実装方法と異なる処理

確認の深さは、次の考え方で決めます。

問題が起きる可能性
    ×
問題が起きた場合の影響
    ×
テストや監視で発見しにくい度合い

リスクが高い箇所では、差分だけでなく、関連する既存コード、テスト、仕様、呼び出し元、呼び出し先まで確認します。

変更の外側への影響を確認する

重要度:高

変更された差分が正しくても、その変更を利用する既存処理に問題が起きる可能性があります。

例えば関数の引数や戻り値が変わった場合、関数自体が正しくても、呼び出し側が新しい仕様に対応できていないかもしれません。データ構造を変更した場合は、次のような箇所への影響も考えます。

  • データを登録・取得する処理
  • APIのリクエストとレスポンス
  • バッチ処理
  • キャッシュ
  • ログと監視
  • 既存データとの互換性
  • 他システムとの連携

変更対象を中心として、入力元、出力先、呼び出し元、呼び出し先をたどり、影響範囲を確認します。

レビューで確認する観点

仕様を満たしているか

重要度:最高

最初に、今回の変更が要求された仕様を満たしているか確認します。

実装がきれいで、テストが通っていたとしても、求められた機能と異なっていれば正しい変更とはいえません。正常系だけでなく、仕様に含まれる例外条件、対象外の条件、既存仕様との整合性も確認します。

また、コードから仕様を推測するだけでなく、PRの説明、チケット、仕様書と実装を対応させて確認します。仕様自体に曖昧さや矛盾があれば、コードの修正を求める前に認識を合わせます。

動作上の問題がないか

重要度:高

仕様を満たす実装になっていても、実際の動作で問題が起きないかを確認します。

例えば、ユーザーの状態を「有効」から「無効」へ変更する処理なら、正常に変更できることだけでなく、すでに無効な場合、対象が存在しない場合、同時に更新された場合なども考えます。

特に次の観点を確認します。

  • 正常系が期待どおりに動くか
  • 異常系で適切に終了・復旧できるか
  • データの不整合や中途半端な更新が起きないか
  • 既存機能を壊していないか
  • セキュリティや性能に問題がないか
  • ログや監視で問題を把握できるか

確認やテストは十分か

重要度:高

実装者による動作確認が行われているか、必要なテストが実装されているかを確認します。

ユニットテストの有無だけでなく、テストの観点やパターンが十分かを見ることが重要です。

  • 正常系が確認されているか
  • 異常系や境界値が確認されているか
  • 条件分岐ごとの重要なパターンを網羅しているか
  • 不具合修正の場合、再発を防ぐテストがあるか
  • テストが実装の詳細ではなく、期待する振る舞いを確認しているか
  • 変更による影響範囲に応じたテストが行われているか

テストコードが多いこと自体ではなく、仕様とリスクに対応した確認になっているかを見ます。

保守性が保たれているか

重要度:高

今回の変更が動くかだけでなく、今後も安全に変更できるコードになっているかを確認します。

  • 責務が適切に分かれているか
  • 名前から役割や意図を理解できるか
  • 複雑な条件や処理が必要以上に入り組んでいないか
  • 重複したロジックがないか
  • 既存の設計や実装方針と整合しているか
  • 将来の仕様変更で修正箇所を限定できるか

判断に迷ったときは、「数か月後、実装時の記憶を失った自分や別のメンバーが、このコードを理解して安全に変更できるか」と考えます。

コード規約に沿っているか

重要度:低

チームにコード規約がある場合は、ルールに沿った実装になっているか確認します。また、言語上は実装可能でも、チームとして避けている書き方になっていないかも確認します。

ただし、コード規約を軽視しているわけではありません。文法、フォーマット、単純な命名規則など、機械的に判定できる項目へ人間のレビュー工数を使うのは、費用対効果が低いと考えています。

可能な限りLinter、Formatter、静的解析、CIで検出し、人間は自動化しにくい判断に集中するのが理想です。

指摘するときの注意

指摘の仕方に気を付ける

重要度:最高

指摘内容が正しくても、伝え方が不明確だったり攻撃的だったりすると、修正の品質やチーム内の関係に悪影響を与えます。

コメントを書くときは、次の点を意識します。

  • どこに問題があるのかを明確にする
  • なぜ問題になるのかを説明する
  • 必要であれば変更案や変更時の注意点を伝える
  • 必須の修正、提案、質問を区別する
  • コードや判断について述べ、人を評価しない

実装者は「問題ない」と判断してレビューへ出しているはずです。その前提に立ち、相手にも判断できるだけの理由を伝えます。指摘は必要ですが、中傷にならないようにします。

コメントの例として、次のように意図を添えると伝わりやすくなります。

この条件では対象が0件のときにも後続処理へ進むように見えます。外部APIへ空のリクエストを送る可能性があるため、ここで早期リターンするのはどうでしょうか。

一方で、単に「ここは早期リターンにしてください」と書くだけでは、変更理由や重要度が伝わりにくくなります。

本当に変更が必要かを考える

レビューコメントを書く前に、「この変更は本当に必要か」を自問します。

修正を依頼すれば、相手の工数が発生します。好みの違いを解消するためだけの変更や、得られる価値より変更コストの方が大きい指摘になっていないかを考えます。

次の観点から、コメントの必要性を判断します。

  • 仕様、品質、安全性に影響するか
  • 将来の保守コストを実際に下げられるか
  • チームの合意済みルールに関わるか
  • 今回のPRで直すべきか、別の課題として扱うべきか
  • 修正によって別のリスクを増やさないか

指摘の数を増やすことではなく、変更コストに見合う価値を生むことを重視します。

レビューイーの注意点

セルフレビューする

第三者にレビューしてもらう前に、自分で確認できることは確認します。

レビューアーの観点を使って差分を読み直し、仕様、動作、テスト、保守性、影響範囲を確認します。可能であれば、実装直後ではなく、数時間から1日程度おいて見直します。時間をおくと、実装時の思い込みから少し離れ、自分の仕事を客観視しやすくなります。

また、Linterやテスト、AIによる事前レビューなどを利用し、人へ依頼する前に機械で検出できる問題を減らします。

指摘の背景を理解する

レビューアーからの指摘を、最初から否定しないようにします。まず、相手がどこに違和感を持ち、何を問題だと考えたのかを理解します。

実装者は背景を深く理解している一方で、実装時の前提や記憶に強く影響されています。第三者が理解しにくいと感じた箇所は、将来、実装時の記憶を失った自分にとっても理解しにくい可能性があります。

ただし、すべての指摘へ無条件に従うという意味ではありません。納得できない場合や、修正の利点を見いだせない場合は、意図を確認して話し合います。仕様、保守性、変更コストを踏まえ、チームとして判断することが重要です。

感情と技術的判断を分ける

自分では十分に確認したつもりでも、指摘を受けると良い印象を持てないことがあります。

そのようなときも、指摘された自分と、指摘されたコードを分けて考えます。レビューは人を採点するためではなく、より良い品質の仕事をするための機会です。

すぐに反応せず、指摘の意図と技術的な妥当性を落ち着いて確認するようにします。

レビューを支える仕組み

レビュー規約を整える

必要に応じて、チーム内でレビューのルールを整えます。

例えば、次のような内容です。

  • レビューの目的と確認範囲
  • PRの大きさや説明に関する基準
  • コメントの分類方法
  • 誰が承認するか
  • 緊急時の扱い
  • セルフレビューで確認する項目

規約は作って終わりではありません。実際の運用で負担や不足が見つかれば、チームで継続的に更新します。

自動化を充実させる

スクリプトやCIを使い、自動化できる確認は自動化します。

  • Formatterによる形式の統一
  • Linterによる規約違反の検出
  • 静的解析による不具合候補の検出
  • ユニットテスト、結合テストの自動実行
  • カバレッジや複雑度などの可視化
  • 依存ライブラリや脆弱性の検査

自動化には、単純な工数削減だけでなく、レビューアーの集中力を重要な判断へ残す効果があります。結果として、人間によるレビューの質も高められます。

AIによるレビューを活用する

AIによるレビューも、事前確認や補助として積極的に活用します。

例えば、次のような用途があります。

  • セルフレビュー時に見落とし候補を洗い出す
  • 変更内容や影響範囲を要約する
  • テスト観点の不足を確認する
  • 複雑な処理を説明させ、理解を補助する
  • コーディング規約や典型的な不具合を検出する

ただし、AIの指摘が常に正しいとは限りません。プロジェクト固有の仕様や背景を十分に理解できない場合もあります。最終的な判断は人間が行い、AIは人間の認知を補助するものとして利用します。

最後に

レビューをすることも、されることも、工数的・精神的に簡単ではありません。それでも、品質を守り、知識を共有し、チームとしてより良いソフトウェアを作るために重要な活動です。

私が大切にしたいのは、すべてのコードを同じ密度で見ることではありません。変更を構造化し、システムの動作をイメージし、リスクの高い場所へ人間の集中力を配分することです。そして、自動化できるものは機械に任せ、人間は仕様、影響、保守性、対話など、人間だからこそ価値を出せる判断に集中します。

レビューする側は、相手の工数を使うことを忘れず、必要性と伝え方を考えます。レビューされる側は、指摘を自分への評価と捉えず、より良い成果物を作るための材料として向き合います。

レビューは間違い探しや採点ではなく、チームで品質を作るプロセスです。お互いの時間と知識への感謝を忘れず、仕組みと対話の両面から、より良いレビューを作り続けたいと考えています。

Docker管理のためにRancher Desktopをインストールして使う

はじめに

Dockerを管理するツールとしてRancher Desktopを使えるようにする方法を説明します。

Rancher Desktopを使う理由

  1. Docker Desktopの有料化の影響

Dockerの管理ツールとしての候補としては Docker Desktop があります。

公式ツールなので、機能が十分であったり、サポートプランがありますが、

ただ、Docker Desktopをつかう場合には、条件次第でライセンス費用1が発生します。

比較的大きめの事業をされている企業での利用や、所属企業でRancherを利用しているので環境を揃えたい場合などに利用する理由になりえます。

  1. Dockerの管理操作のための十分な機能

Dockerの管理のための機能が十分に備わっています。

  • GUIによる直感的な操作
  • docker コマンドなどが付属されており、CLI操作も利用可能になる
  • コンテナイメージの管理操作、kubernetesの操作・環境利用

インストール

Docker Desktopなど他管理ツールの削除(インストール済みの場合)

Docker Desktopなど、他の管理ツールをインストール済みの場合に必要です。

事前に削除するのをお勧めします。

Docker Desktopに付属しているdockerコマンドと重複したり、機能の衝突で正しく動かなくなる可能性があるためです。

Windowsの場合

コントロールパネルからプログラムのアンインストールをしてください。

コントロールパネル=>プログラム=>プログラムのアンインストール を選択します。

ダイアログが開き、中にアプリケーションの一覧があるので、その中からDocker Desktopを選択し「アンインストール」をクリックします。

さらに表示されるダイアログから削除の確認をされるので「はい」を選択して削除を実行します。

Macの場合

Docker DesktopのアプリをMacのアプリ一覧からゴミ箱に移動させます。

Finderを開き、左側の一覧から「アプリケーション」を選択します。

アプリケーションの一覧から「Docker Desktop」を選択肢、ゴミ箱み移動させます。

不要であればゴミ箱を空にしてファイルを削除してください。

インストーラーをダウンロード

以下のサイトからインストーラーを取得し、アプリケーションをインストールします。

Rancher Desktop by SUSE

自分の環境(Mac、Windowsなど)にあったインストーラーを選択し、ダウンロードを開始します。

インストーラーの実行

ダウンロードが完了後、インストーラーを実行します。

承認や設定を確認後、インストールを開始します。完了するまで待ちます。

システム変更の確認が出る可能性がありますが、基本的には承認して継続します。

(管理者権限の確認や、WIndowsサブシステムの権限変更のため。その他の不審な確認があった場合は注意や中断をしてください)

完了した後、設定反映のための再起動を促されますので、準備してから再起動します。2

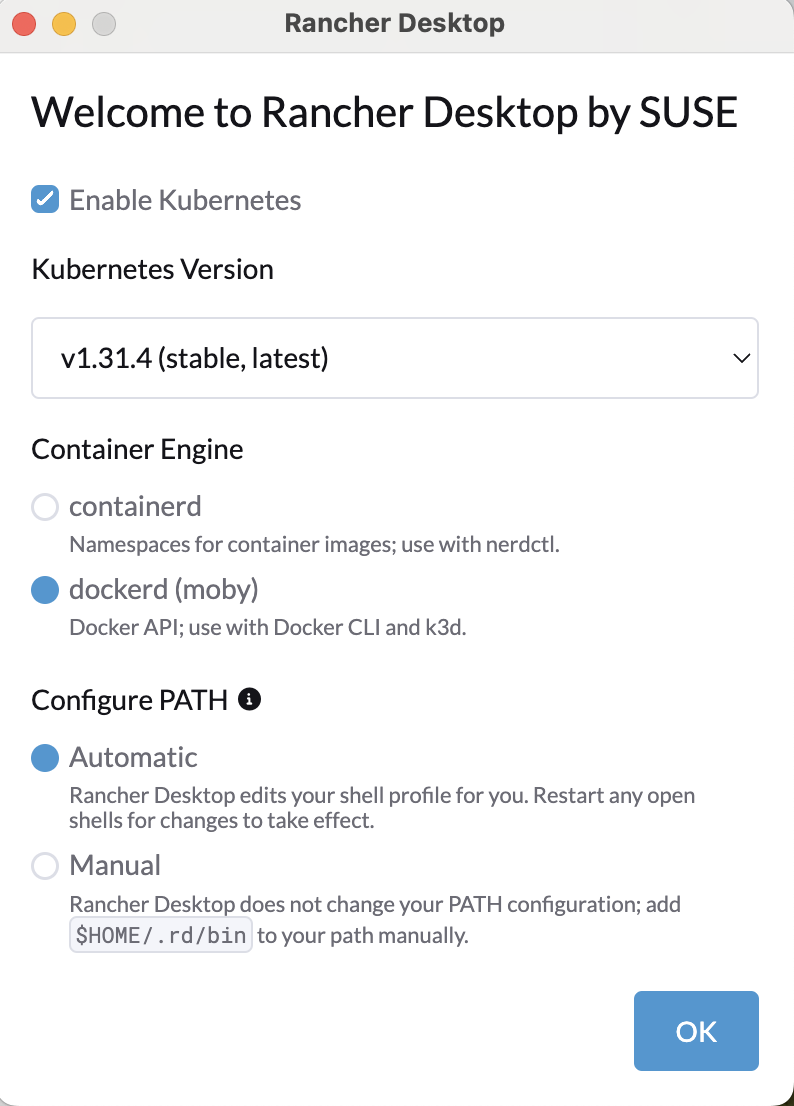
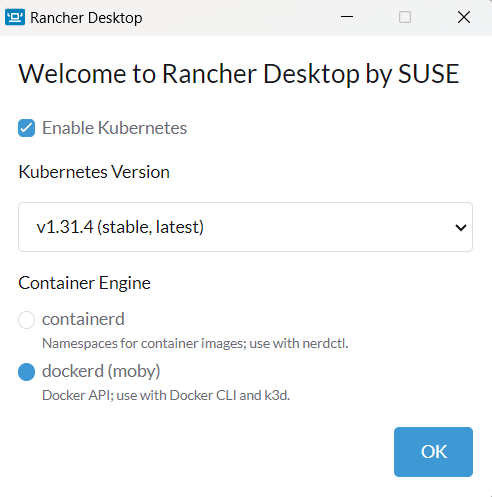
起動、初期設定

アプリケーションを起動します。

以下のような画面が出てくると思います。

インストール時、Macの場合
インストール時、Windowsの場合

初期設定のまま問題ないので今回はこのまま進みます。

(必要がある場合は応じて変更してください。)

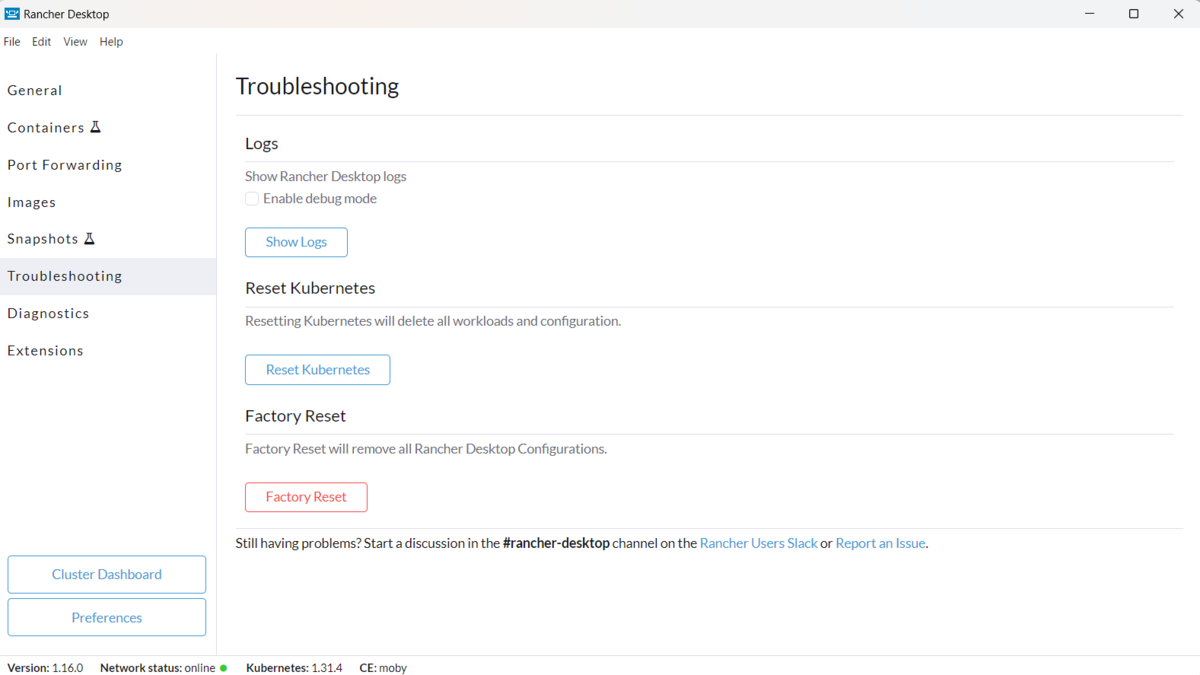
以下の画面になれば起動完了です。

Dockerを動かすための環境としてRancher Desktopの起動している状態が必要になります。この状態で完了です。

動作確認

Dockerが使えるようになっていることを確認します。

以下のコマンドは例です。LinuxのDockerが起動できるようになったことを確認します。

docker run --rm rockylinux:9.3-minimal echo hello rancher
Unable to find image 'rockylinux:9.3-minimal' locally
9.3-minimal: Pulling from library/rockylinux
8ec988941d66: Pull complete
Digest: sha256:305de618a5681ff75b1d608fd22b10f362867dff2f550a4f1d427d21cd7f42b4
Status: Downloaded newer image for rockylinux:9.3-minimal
hello rancher

dockerコマンドが正常に実行できたので成功です。

補足:

Rancher Desktopが起動していないと、以下のようにエラーになります(docker daemonに接続できないエラー)。

>docker run --rm rockylinux:9.3-minimal echo hello rancher
docker: error during connect: in the default daemon configuration on Windows, the docker client must be run with elevated privileges to connect: Head "http://%2F%2F.%2Fpipe%2Fdocker_engine/_ping": open //./pipe/docker_engine: The system cannot find the file specified.
See 'docker run --help'.

[option] 詳細設定

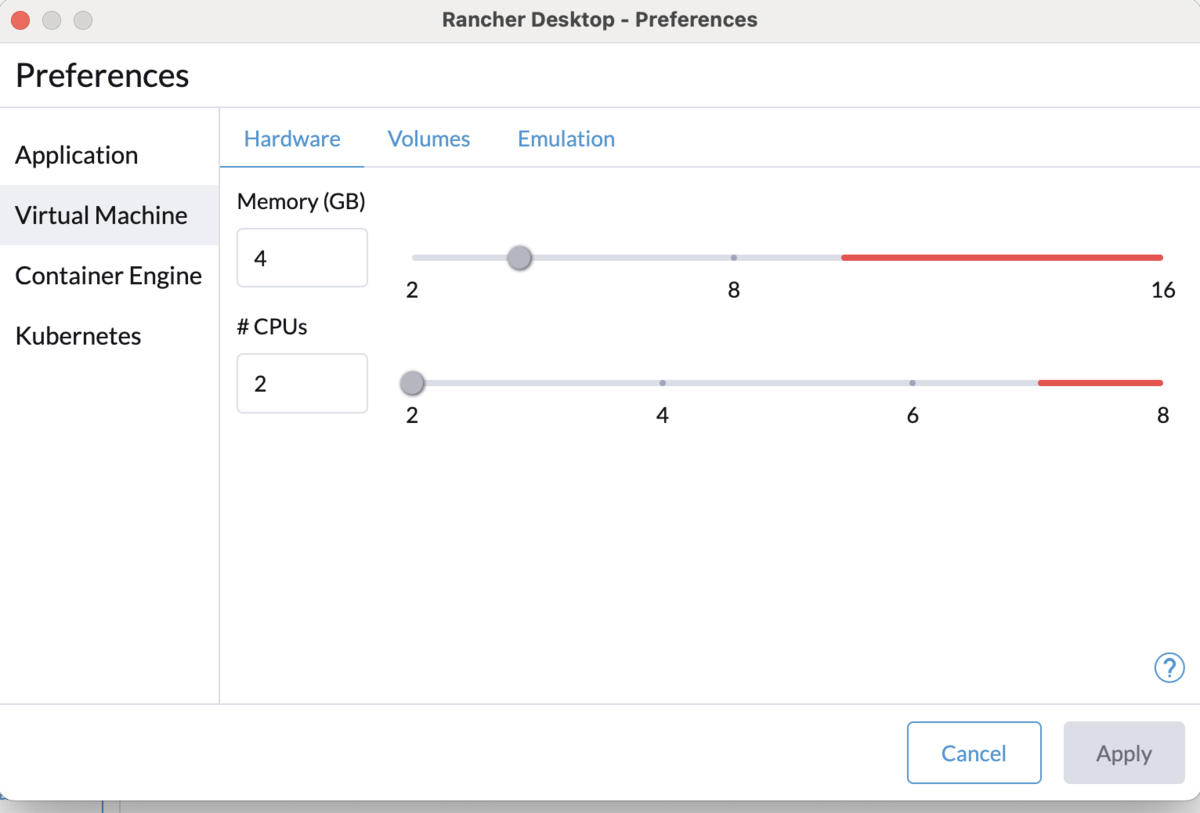
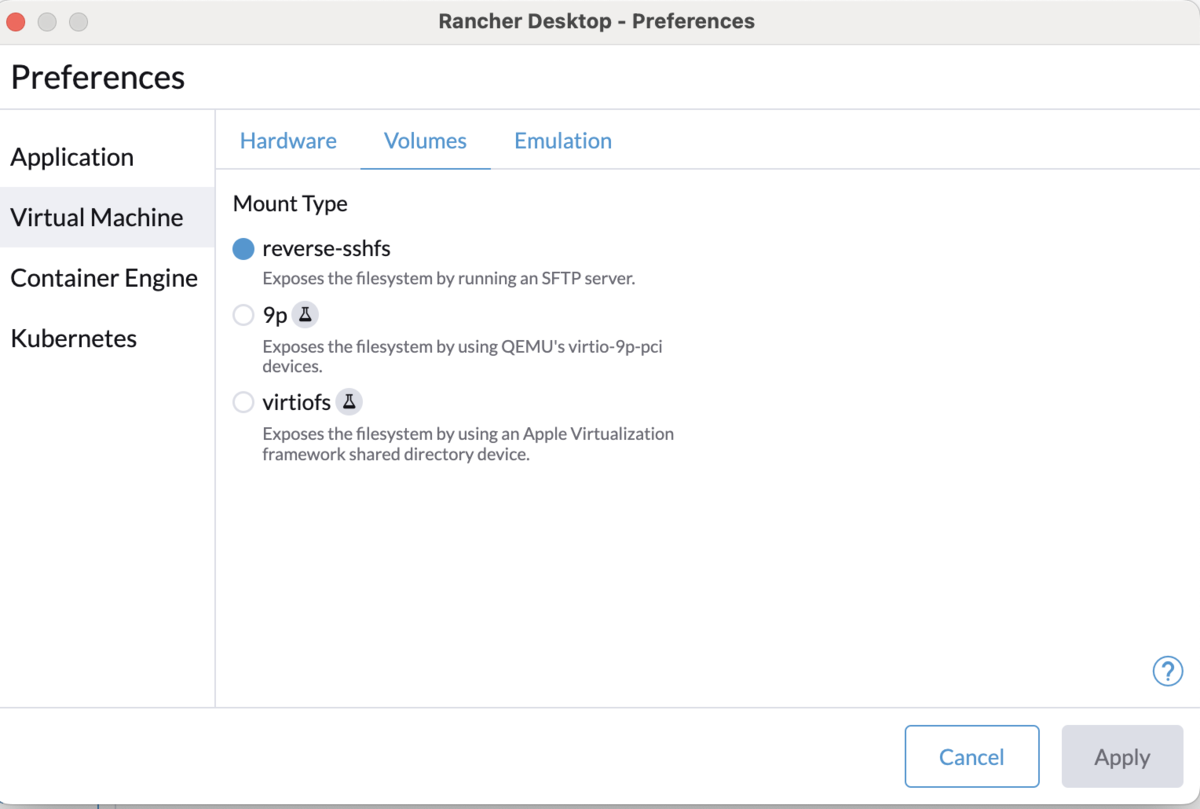
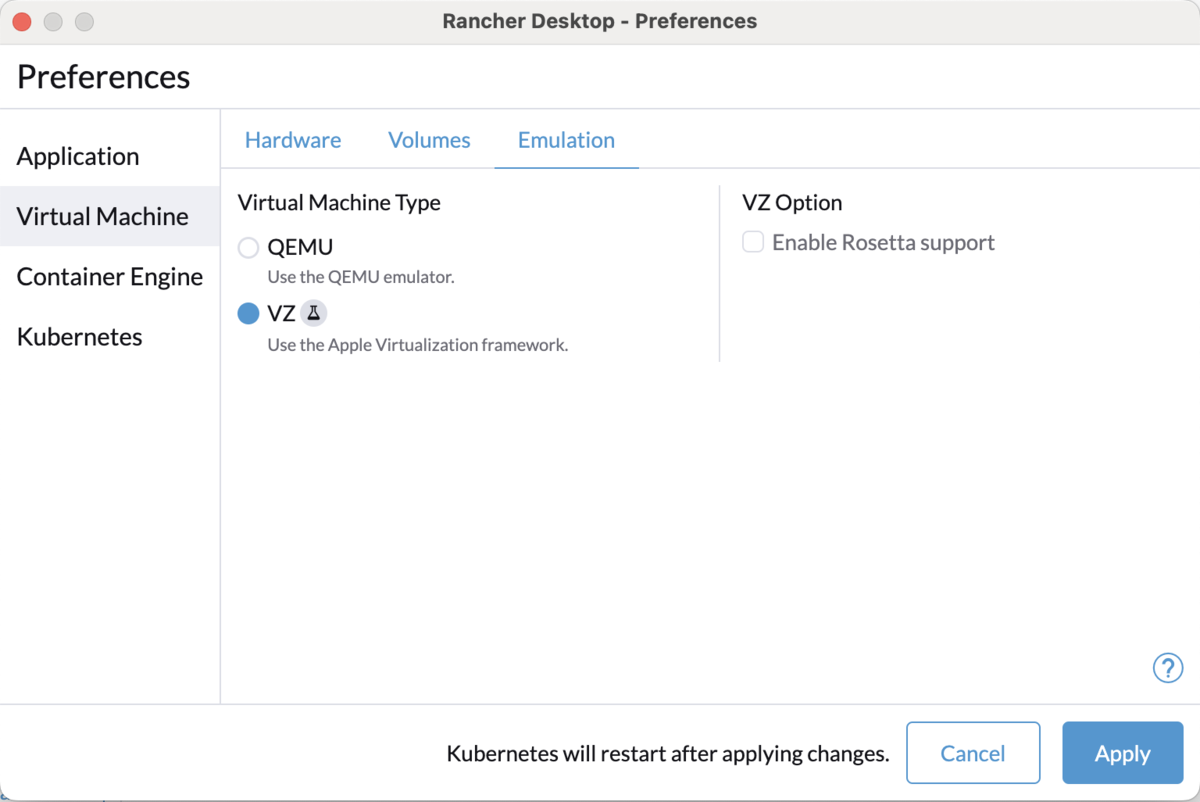
Macの場合、設定に「Virtual Machine」という項目があります。

VM設定:HW
VM設定:volumes
VM設定:Emulation

環境に応じて設定を変更してください。

設定の推奨や意図については以下の通り。

設定タブ名 設定値 説明
Hardware Memory: 8, CPU: 4 dockerを使用するときに使うリソースの上限。利用状況やホストPCの性能と相談
Volumes virtiofs Apple仮想化を利用してファイルパスを共有ディレクトリとしてマウント。EmurationでVZを利用しているからも理由。
reverse-sshfsだとssh経由でのマウントのため、セキュアだがファイル操作に制限がある(権限変更など)。特に操作が不要なら他の設定でも可
Emuration VZ Apple仮想化システムを使う設定。
古いMacOS(12.3以下)を使っていた時にQEMUを使うとメモリ不足に陥る事象があった時の名残3

最後に

以上で設定は完了です


  1. 2025年時点では250名以上または年間収益$10,000,000以上の商用利用の場合に適応。2021年8月31日から有効(2022年1月31日まで猶予)。 https://www.docker.com/ja-jp/legal/docker-subscription-service-agreement/↩
  2. 何も考えずに再起動実行をOKしてしまうと、別アプリやブラウザの作業中のデータが消える恐れがあります。私のように。↩
  3. https://github.com/lima-vm/lima/issues/795↩